  你有没有试过给AI丢一段视频,再配上三五张人物正脸、侧脸、背影、穿不同衣服的参考图,让它生成描述?结果它可能把背影说成另一个人,把格子衬衫认成条纹衫,甚至把没出现的干扰图硬塞进句子里——不是模型瞎,是它根本没被教会‘谁该对上谁’。
  这不是个别现象。快手、城大和伊利诺伊大学等团队近年反复验证:主流VLM在单图+单视频时挺稳,一旦参考图超过5张,尤其当同一人有多个角度/光照/姿态的图片混在一起,模型就开始‘指鹿为马’。它能说出‘男人站在窗边’,但分不清这句里的‘男人’到底对应哪张图——是戴眼镜那张?还是穿蓝外套那张?抑或两张都是同一个人?
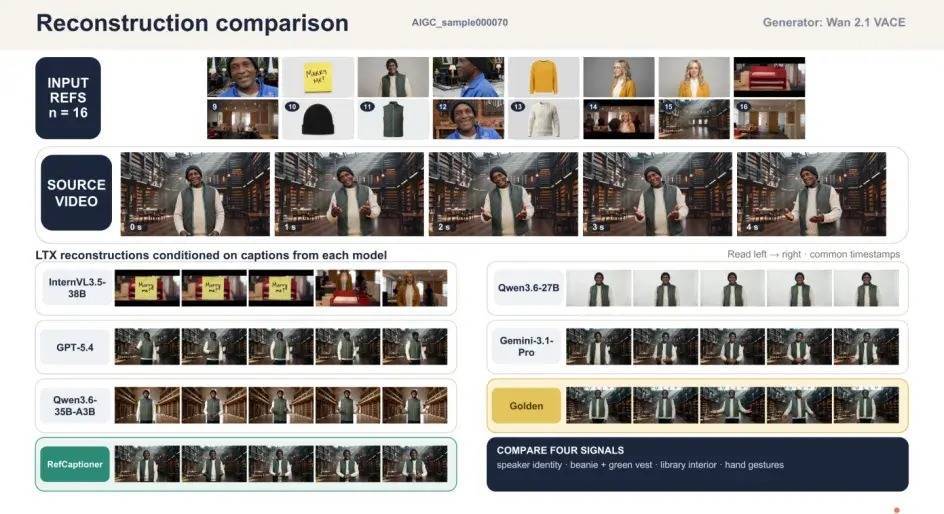
  RefCaptioner干的就是‘配对中介’的活儿。它不只输出一句话,而是结构化输出:场景→人物→外貌→动作,每个短语后紧跟对应的参考图ID(比如“穿红裙子的女人(图3)”、“左转回头(图7,图9)”)。更关键的是,它用双层奖励函数HCD-GRPO,在训练中逼模型做两件事:一是主动拒掉相似但无关的干扰图(比如同款裙子但不同人),二是把多张图归并到同一实体下(同一人不同角度≠两个人)。实测在22张候选图里,准确匹配率比基线模型高出近40%。
  说白了,以前VLM是‘看图说话’,现在RefCaptioner让它变成‘指着图说话’。这不是炫技,而是多参考图视频编辑、个性化生成落地的刚需——毕竟,你让AI复刻一个角色,总不能靠它自己猜哪张图才是‘正主’吧?
  顺便提一句,这背后暴露的其实是VLM长期被忽略的短板:它擅长‘理解整体’,却弱于‘绑定局部’。就像人能一眼认出朋友,但AI得靠显式建模才能把‘朋友的脸’和‘朋友的手势’‘朋友的衣服’全串成同一个人。RefCaptioner没重造轮子,只是给现有VLM加了一副‘带标尺的眼镜’。
  这副“带标尺的眼镜”,其实悄悄改写了人和AI协作的节奏。以前你得反复删改提示词:“不是这张!是第三张!对,就是那个戴银耳钉、扎低马尾的!”现在一句话甩过去,模型自己就能把图3、图5、图12自动归为同一角色,连发型变化(图3是直发,图12是微卷)和光照差异(图5背光,图12侧打光)都主动对齐——不是靠猜,是靠训练时被强制要求做“身份一致性检查”。
  更实在的变化发生在应用端。淘宝商家用RefCaptioner给新品视频配描述,上传6张模特不同角度图后,生成文案直接标注“V领针织衫(图2)、高腰阔腿裤(图4,图6)、抬手撩发动作(图1,图5)”,剪辑师按ID找图,10秒内就能调出对应镜头;B站UP主做动漫角色二创,丢进原设图+3张同人图+2张Q版变体,模型能明确区分“本体(图1-3)”和“Q版形态(图4-5)”,避免把Q版表情套到写实脸型上。
  有人担心:加了这么多约束,会不会让生成变死板?实测恰恰相反。因为模型不再需要“脑补”人物关系,省下的算力全用在细节打磨上——衣服褶皱走向更自然,光影过渡更连贯,连手指弯曲角度都更符合物理逻辑。就像开车时不用再分心看后视镜是否对准,反而能把注意力放在路况判断上。
  当然,它也不是万能钥匙。遇到严重遮挡(比如只露半张脸+口罩)、跨年龄跨度大(童年照+成年照),或参考图里混入高度相似的双胞胎,匹配精度还是会掉。但团队已在论文附录中公开了失败案例库,连错误类型都打了标签:ID混淆、姿态误判、服饰泛化……这不是藏着掖着,而是把“AI哪里会犯错”摊开来讲,方便下游开发者针对性补位。
  说到底,RefCaptioner没让AI突然变聪明,只是让它学会了一件人类从小就在做的事:不光看见东西,还要记住“这个东西是谁的”。而技术往前走一小步最新股票配资,可能就是普通人离“所想即所得”近了一大截——毕竟,谁都不想对着AI喊:“等等!那是我表姐,不是我!”
倍悦网配资提示:文章来自网络,不代表本站观点。
相关文章


热点资讯
